

AWS에서 Laya를 통한 Decision Model 학습 및 배포 환경 구성하기
Laya를 SageMaker에서 학습·배포해 한국어 개인정보를 확률 기반으로 판정하는 구성을 설명했습니다. 데이터 설계, 운영 규칙, 성능 비교와 재학습 시 유의점을 함께 정리했습니다.
#Laya#Amazon SageMaker
200
Laya를 SageMaker에서 학습·배포해 한국어 개인정보를 확률 기반으로 판정하는 구성을 설명했습니다. 데이터 설계, 운영 규칙, 성능 비교와 재학습 시 유의점을 함께 정리했습니다.

AI Agent와 검증 루프로 요구사항부터 구현·감사까지 자율 진행하는 그래프 기반 개발 방법론을 소개했습니다. 백엔드 공수와 전체 비용 절감 사례, 루프 안정화와 모호한 기획 문서의 과제를 함께 다뤘습니다.
Image AI 서빙을 LitServe로 전환하고 CPU·GPU 대기 및 불필요한 연산을 줄였습니다. 트래픽 기반 튜닝과 GPU 공유로 H100 환산 약 67장을 절감했습니다.
실물 TV와 리모컨 신호에 의존하던 TV 앱 실행 시간 측정 작업을 다룹니다. PC와 USB IR 송신기를 활용해 반복 측정 자동화를 개발했습니다.
클로드 코드와 피그마로 디자인 시스템 컴포넌트를 만들며 발생한 맥락·기억 누락 문제를 다뤘습니다. 결정 기록, 작업 가이드, 안전 장치, 검수 에이전트로 작업 파이프라인을 안정화했습니다.
제품 코드와 Claude를 결합해 최신 화면 기반 프로토타입·PR 핸드오프 방식을 구축했습니다. 가이드 스킬과 팀 플러그인으로 PM까지 디자인 작업에 참여하도록 확장했습니다.
AI와 사람이 함께 활용할 디자인 시스템 재설계 원칙과 문제를 정리했습니다. 기준 문서와 슬롯 정책으로 컴포넌트 사용성과 통제력을 높였습니다.
14년 된 카페 관리도구를 AI로 분석하고 Storybook·MSW로 재현한 개편 사례를 공유합니다. 신규 스튜디오 개발 과정에서 달라진 기획·디자인·백엔드 협업 방식을 소개합니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
검색·피드·광고 데이터를 연결하는 버티컬 추천 모델의 개발과 적용 경험을 소개합니다. 실시간 GPU 서빙 최적화와 지식 증류 기반 도메인 간 지식 전이를 다룹니다.

MoE Gemma 4 26B의 전문가 절반을 가지치기해 노트북 내장 GPU에서 카페 주문 처리를 검증했습니다. 일반 지식은 감소했지만 64e는 실전 성능을 유지했으며, 과도한 가지치기는 사람 평가에서 드러났습니다.
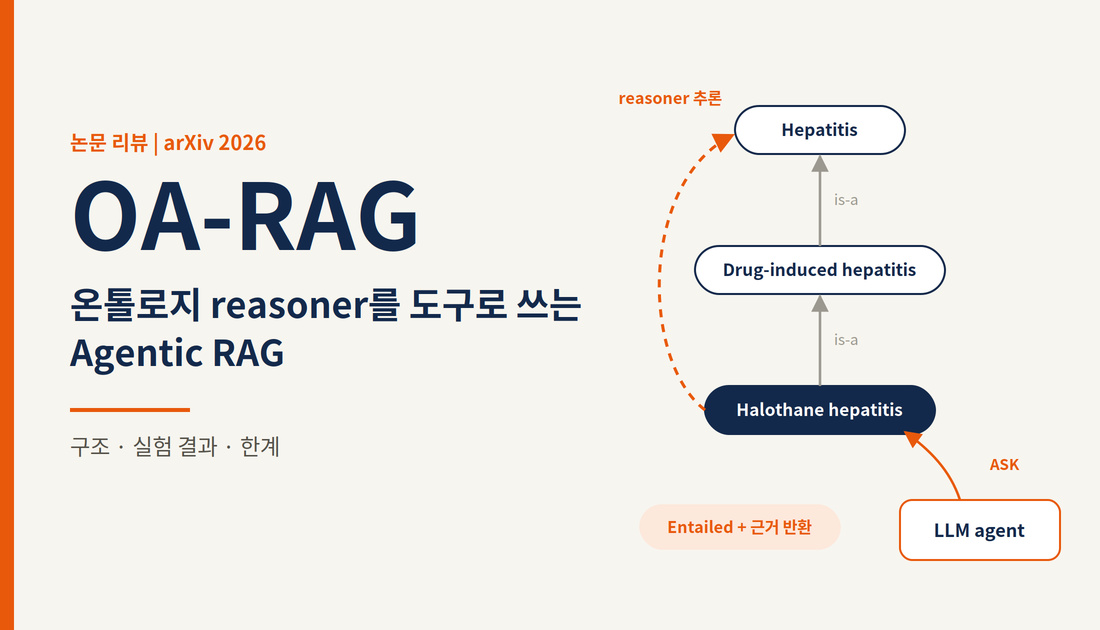
OA-RAG의 온톨로지 reasoner·LLM 결합 구조와 실험 결과를 분석했습니다. 의료 QA의 효율성과 평가 편향, grounding 신뢰도 한계를 함께 짚었습니다.
Arm AI Model Optimizer로 엣지 NPU와 클라우드 CPU용 모델 최적화 핸즈온을 소개했습니다. 양자화와 그래프 최적화로 지연 시간·모델 크기를 줄이고 정확도를 유지한 결과를 공유했습니다.
서로 다른 벤더의 AI가 구현과 검토를 나누는 weave-agents를 소개했습니다. 의견 충돌은 코드와 테스트로 확인하는 협업 방식을 다뤘습니다.

AWS Emulator로 계정과 자격 증명 없이 로컬·CI에서 AWS 통합 테스트를 실행하는 방법을 설명했습니다. 환경 변수 격리와 계정 확인 가드, 실제 AWS 검증을 함께 권고합니다.